Lokale KI, Teil 2: Der Test war zu leicht
In Teil 1 haben wir zwei lokale Sprachmodelle mit 17 festen Aufgaben verglichen. Seitdem sind zwei neue Modelle dazugekommen, und eines davon hat den Test gesprengt: 17 von 17 Punkten in zwei Minuten. Ein Test, den ein Modell fehlerfrei besteht, misst nichts mehr. Also haben wir die Anforderungen verschärft.
Der Rechner ist derselbe: ein MacBook mit M5 Max und 128 GB Arbeitsspeicher.
Die neuen Modelle
| Modell | Bauart | Speicher | Denkt vor der Antwort? | Server |
|---|---|---|---|---|
| Qwen3-Coder-Next, 8 bit | 80 Milliarden Gewichte, davon rund 3 Milliarden aktiv | ~85 GB | nein | LM Studio (MLX) |
| gpt-oss-120b, MXFP4 | 117 Milliarden Gewichte, davon rund 5 Milliarden aktiv | ~59 GB | ja, kurz | LM Studio (GGUF) |
| Qwen3.8-27B, 8 bit (aus Teil 1) | 27 Milliarden Gewichte, alle aktiv | ~30 GB | ja, lang | LM Studio (MLX) |
Beide neuen Modelle sind Mixture-of-Experts-Modelle: Sie sind groß, aber für jedes Wort rechnet nur ein kleiner Teil mit. Deshalb sind sie trotz ihrer Größe schnell. Flash-Next aus Teil 1 ist in dieser Runde nicht dabei.
Warum der erste Test nicht mehr reichte
Qwen3-Coder-Next hat den Aufgabensatz aus Teil 1 komplett gelöst:
| Modell | Punkte (Satz 1) | Tempo | Laufzeit |
|---|---|---|---|
| Qwen3-Coder-Next | 17 / 17 | ~65 Tokens/s | 2 min |
| Qwen3.8-27B | 16 / 17 | ~14 Tokens/s | 45 min |
| Flash-Next 2 bit | 13,5 / 17 | ~38 Tokens/s | 37 min |
Weil Coder-Next nicht vorab „denkt“, gibt es bei ihm auch keine Hänger im Endlos-Denken, das Hauptproblem aus Teil 1. Beim Gegenlesen fielen nur Kleinigkeiten auf, etwa ein falscher Paragraf in einer Antwort, den die automatische Prüfung nicht bemerkt hat.
Damit war klar: Die Aufgaben trennen gute Modelle nicht mehr von sehr guten.
Der neue Test: 19 schwerere Aufgaben
Den alten Satz haben wir nicht verändert, damit alte Ergebnisse vergleichbar bleiben. Der neue Satz steht daneben. Die genauen Texte bleiben wieder unveröffentlicht, sonst landen sie in den Trainingsdaten.
| Gruppe | Aufgaben | Was geprüft wird | Wie bewertet |
|---|---|---|---|
| Reasoning | 5 | Logikrätsel, Wahrscheinlichkeit, Werktage, eine Rechnung mit eingebauter Falle | exakte Antwort |
| Code | 4 | Formeln auswerten, Arbeitstage mit Feiertagen, Gewinne nach Kaufreihenfolge, Zwischenspeicher mit Ablaufzeit | echte Unit-Tests, Teilpunkte |
| Agent | 3 | Fehler in einem kleinen Projekt beheben, Recherche mit Fallen, eine Stornierung mit Verwechslungsgefahr | versteckte Tests, Endzustand |
| Kontext | 1 | verteilte Fakten in rund 55 000 Tokens Text, eine Angabe darin ist veraltet | richtige Antwort |
| Anweisung, Struktur, Tools | 3 | Formatvorgaben, Rechnung als JSON mit Mehrwertsteuer, relative Zeitangabe | Feldvergleich |
| Deutsch | 2 | Text korrigieren, einen Sachverhalt mit Wortgrenze erklären | Regeln automatisch |
| Ehrlichkeit | 1 | Gibt das Modell zu, wenn es etwas nicht wissen kann? | lesen |
Neu sind vor allem die Agenten-Aufgaben. Dort bekommt das Modell Werkzeuge: Es darf Dateien lesen, Tests starten und Ergebnisse ansehen, und zwar in mehreren Runden hintereinander. So arbeiten Programmier-Agenten wie Cline oder opencode im Alltag. Bewertet wird nicht die Antwort, sondern ob am Ende das Richtige passiert ist.
Die Einstellungen sind wie in Teil 1: Temperatur 0,6 und höchstens 16 384 Tokens pro Antwort.
Ergebnis
| Modell | Punkte | Reasoning | Code | Agent | Kontext | Übrige | Tempo | Laufzeit |
|---|---|---|---|---|---|---|---|---|
| gpt-oss-120b | 18,3 / 19 | 5 / 5 | 4 / 4 | 3 / 3 | 1 / 1 | 5,3 / 6 | ~50–70 Tokens/s | 8 min |
| Qwen3.8-27B | 16,8 / 19 | 5 / 5 | 2 / 4 | 3 / 3 | 1 / 1 | 5,8 / 6 | ~13 Tokens/s | 3,7 h |
| Qwen3-Coder-Next | 14,8 / 19 | 5 / 5 | 1,2 / 4 | 3 / 3 | 1 / 1 | 4,6 / 6 | ~65 Tokens/s | 4 min |
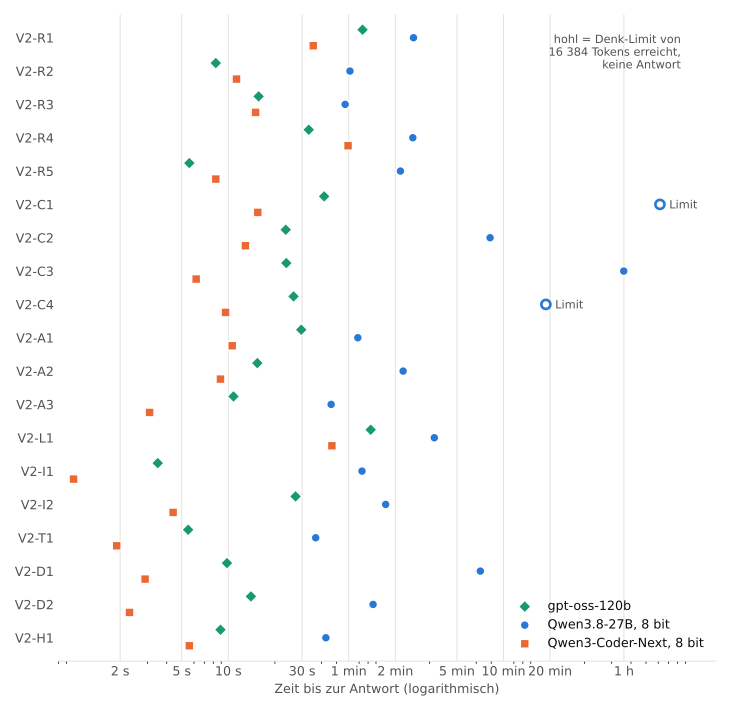
Der Sieger aus dem ersten Test liegt im schwereren Test hinten. Und ein Modell, das in Teil 1 noch gar nicht dabei war, löst fast alles.
gpt-oss-120b: kurz denken, richtig antworten
gpt-oss-120b ist ein Denkmodell, aber es denkt knapp: meist 300 bis 2 500 Tokens, im längsten Fall rund 5 400. Kein einziger Hänger. Alle vier Code-Aufgaben bestehen sämtliche Tests, alle Agenten-Aufgaben sind richtig.
Punkte verliert es nur im Deutsch-Teil. Eine Erklärung hatte 126 statt höchstens 120 Wörter, und beim Korrigieren blieb einer von sechs Fehlern stehen („das Geschäft, dass“). Lässt man die beiden Deutsch-Aufgaben weg, sind es 17 von 17 Punkten.
Dazu braucht es mit 59 GB deutlich weniger Speicher als Coder-Next.
Qwen3.8-27B: genau, aber sehr langsam
Das 27B macht kaum Flüchtigkeitsfehler. Die Rechnung im JSON stimmt, die Formatregeln hält es ein, die Deutsch-Erklärung ist richtig. In der Gruppe „Übrige“ ist es das beste Modell.
Der Preis ist die Zeit. Der ganze Lauf dauerte rund 3,7 Stunden, davon allein zwei Code-Aufgaben zusammen fast drei Stunden. Bei zwei von vier Code-Aufgaben lief es wieder ins Denk-Limit und gab keine Antwort. Das ist dasselbe Muster wie in Teil 1, nur teurer, weil die Aufgaben schwerer sind. Zwei Code-Aufgaben mussten wir nachholen, weil der erste Versuch schon an unserem Zeitlimit von 30 Minuten scheiterte. Das Limit steht jetzt bei 60 Minuten.
Qwen3-Coder-Next: als Agent stark, aus einem Guss schwach
Coder-Next ist das schnellste Modell und löst alle drei Agenten-Aufgaben fehlerfrei, jede in wenigen Sekunden. Beim Fehlerbeheben ruft es neunmal Werkzeuge auf, startet die Tests, liest das Ergebnis und bessert nach.
Ganz anders sieht es aus, wenn es kniffligen Code in einem Zug schreiben soll. Ohne Denkphase schleichen sich Fehler ein: eine falsche Einrückung, ein Wert, der bei jedem Durchlauf zurückgesetzt wird, ein Zugriff auf einen schon gelöschten Eintrag. Das ergibt 1,2 von 4 Punkten. Wir haben jeden dieser Fehler von Hand nachgeprüft, keiner liegt am Testgerüst.
Das passt zusammen: In der Agenten-Schleife fängt das Modell solche Fehler selbst ab, weil die Tests sie ihm zeigen. Beim direkten Ausgeben sieht es sie nie.
Zwei weitere Schwächen: Es verrechnet sich in Texten (Summen und Mehrwertsteuer in der Rechnung falsch), und in der Deutsch-Erklärung nannte es den falschen Paragrafen.
Was wir daraus mitnehmen
Ein leichter Test belohnt Tempo, ein schwerer belohnt Nachdenken. Im ersten Satz war Coder-Next vorn, im zweiten liegt es hinten. Die Reihenfolge hängt am Schwierigkeitsgrad.
Denken ist nicht gleich Denken. gpt-oss-120b und Qwen3.8-27B denken beide vor der Antwort. Das eine braucht dafür Sekunden, das andere bei Code bis zu 100 Minuten und kommt zweimal gar nicht zum Ende. Ob ein Modell rechtzeitig aufhört zu überlegen, ist wichtiger als die Frage, ob es überhaupt überlegt.
Agenten-Aufgaben sind für alle drei kein Hindernis. Alle drei Modelle holen dort die volle Punktzahl. Die Unterschiede liegen beim Code ohne Rückmeldung.
Ein Lauf bleibt eine Stichprobe. Jedes Modell lief einmal. In Teil 1 schwankten die Ergebnisse von Lauf zu Lauf um ein bis zwei Punkte. Der Abstand zwischen 18,3 und 14,8 ist größer als das, der zwischen 18,3 und 16,8 nicht sicher.
Unsere Empfehlung
| Einsatz | Modell |
|---|---|
| Allround, Code und Agenten | gpt-oss-120b: beste Punktzahl, kein Hänger, 59 GB |
| Programmier-Agent mit Tests (Cline, opencode) | gpt-oss-120b oder Qwen3-Coder-Next; welches im Alltag besser läuft, probieren wir als Nächstes aus |
| eine einzelne Antwort muss genau stimmen, Zeit egal | Qwen3.8-27B, mit Zeitlimit |
Wie es weitergeht
gpt-oss-120b ist auch für den neuen Test fast schon zu gut. Deshalb haben wir einen dritten Aufgabensatz gebaut, der näher an unserer eigenen Arbeit liegt: 14 Rechenaufgaben aus Elektronik und Bauelementephysik, vom Operationsverstärker in der Begrenzung über den belasteten Tiefpass bis zur Schwellspannung eines MOSFET. gpt-oss-120b hat ihn als erstes Modell durchlaufen; die anderen Modelle folgen, dann gibt es Teil 3.
Außerdem offen:
- jedes Modell mehrmals laufen lassen und mitteln,
- Qwen3.8-27B mit kleinerem Token-Limit, damit Hänger früher abbrechen,
- gpt-oss-120b und Coder-Next im echten Einsatz mit einem Programmier-Agenten vergleichen.
Inhalt
- Lokale KI, Teil 2: Der Test war zu leicht
- Die neuen Modelle
- Warum der erste Test nicht mehr reichte
- Der neue Test: 19 schwerere Aufgaben
- Ergebnis
- gpt-oss-120b: kurz denken, richtig antworten
- Qwen3.8-27B: genau, aber sehr langsam
- Qwen3-Coder-Next: als Agent stark, aus einem Guss schwach
- Was wir daraus mitnehmen
- Unsere Empfehlung
- Wie es weitergeht