Lokale KI auf dem MacBook: Qwen3.8-27B gegen Flash-Next
Sprachmodelle laufen inzwischen auch ohne Cloud, direkt auf dem eigenen Rechner. Das ist interessant, wenn Daten das Haus nicht verlassen sollen oder wenn man einfach wissen will, was die Modelle können. Wir nutzen lokale Modelle zum Programmieren und für kleine Hilfsaufgaben. Damit wir neue Modelle fair vergleichen können, haben wir uns einen festen Test gebaut. Hier ist die erste Runde.
Der Rechner und die Modelle
Getestet haben wir auf einem MacBook mit M5 Max und 128 GB Arbeitsspeicher. Beim Mac teilen sich Prozessor und Grafikeinheit denselben Speicher. Deshalb passen dort auch große Modelle hinein, für die man sonst eine teure Grafikkarte bräuchte.
| Modell | Größe im Speicher | Quantisierung | Server |
|---|---|---|---|
| Qwen3.8-27B | ~30 GB | 8 bit | LM Studio (MLX) |
| Qwen3.8-Flash-Next OptiQ | ~80 GB | 2 bit | optiq serve |
Quantisierung heißt: Die Gewichte des Modells werden mit weniger Bits gespeichert, statt 16 nur 8 oder sogar 2 Bit. Das Modell wird kleiner und schneller, verliert aber etwas Genauigkeit.
Die beiden Modelle sind sehr verschieden gebaut. Qwen3.8-27B ist ein dichtes Modell: Für jedes Wort rechnen alle 27 Milliarden Gewichte mit. Flash-Next ist ein Mixture-of-Experts-Modell: Es ist viel größer, aber für jedes Wort arbeitet nur ein kleiner Teil, die passenden „Experten“. Deshalb ist es trotz seiner Größe schneller. Selten gebrauchte Experten liegen auf der SSD und werden bei Bedarf nachgeladen.
Der Test: 17 feste Aufgaben
Die Aufgaben sind immer dieselben, damit alte und neue Läufe vergleichbar bleiben. Die genauen Texte veröffentlichen wir nicht: Was im Internet steht, landet irgendwann in den Trainingsdaten, und dann misst der Test nur noch, was das Modell auswendig kennt.
| Gruppe | Aufgaben | Was geprüft wird | Wie bewertet |
|---|---|---|---|
| Reasoning | 5 | Kombinatorik, Logik, Prozentrechnung, Buchstaben zählen, Kalender | exakte Antwort |
| Code | 4 | Zahlen einlesen, Intervalle, Fehler finden, CSV auswerten | echte Unit-Tests |
| Deutsch | 2 | Zusammenfassung mit Vorgaben, formelle E-Mail | Regeln automatisch, Qualität von Hand |
| Struktur | 1 | Daten aus einem Rechnungstext als JSON herausziehen | Feldvergleich |
| Tools | 3 | richtiges Werkzeug, mehrere Aufrufe auf einmal, kein unnötiger Aufruf | Aufrufe prüfen |
| Ehrlichkeit | 1 | Frage nach einem erfundenen Gesetz: Gibt das Modell zu, dass es das nicht kennt? | lesen |
| Kontext | 1 | eine Nadel im Heuhaufen von rund 24 000 Tokens | gefunden oder nicht |
Jede Aufgabe gibt einen Punkt. Alle Läufe mit Temperatur 0,6 und höchstens 16 384 Tokens pro Antwort. Ein Token ist ein Wortstück, grob drei bis vier Buchstaben.
Ergebnis
| Modell | Punkte | Code | Reasoning | Deutsch | Rest | Tempo | Laufzeit |
|---|---|---|---|---|---|---|---|
| Qwen3.8-27B | 16 / 17 | 3 / 4 | 5 / 5 | 2 / 2 | alles richtig | ~14 Tokens/s | 45 min |
| Qwen3.8-27B, Sampling laut Modellkarte¹ | 15 / 17 | 3 / 4 | 4 / 5 | 2 / 2 | alles richtig | ~14 Tokens/s | 39 min |
| Flash-Next 2 bit | 13,5 / 17 | 1 / 4 | 5 / 5 | 1,5 / 2 | alles richtig | ~38 Tokens/s | 37 min |
¹ Temperatur 1,0, top_p 0,95, top_k 20, so wie es der Hersteller auf der Modellkarte empfiehlt.
Auf den ersten Blick: Qwen-27B gewinnt knapp, Flash-Next ist fast dreimal so schnell. Interessanter ist, warum Punkte verloren gehen.
Das eigentliche Problem: Endlos-Denken
Beide Modelle „denken“ vor der Antwort: Sie schreiben erst eine lange innere Überlegung und dann die eigentliche Antwort. Manchmal hört das Denken nicht mehr auf. Das Modell überlegt, verwirft, überlegt neu, bis das Limit von 16 384 Tokens erreicht ist. Dann gibt es gar keine Antwort.
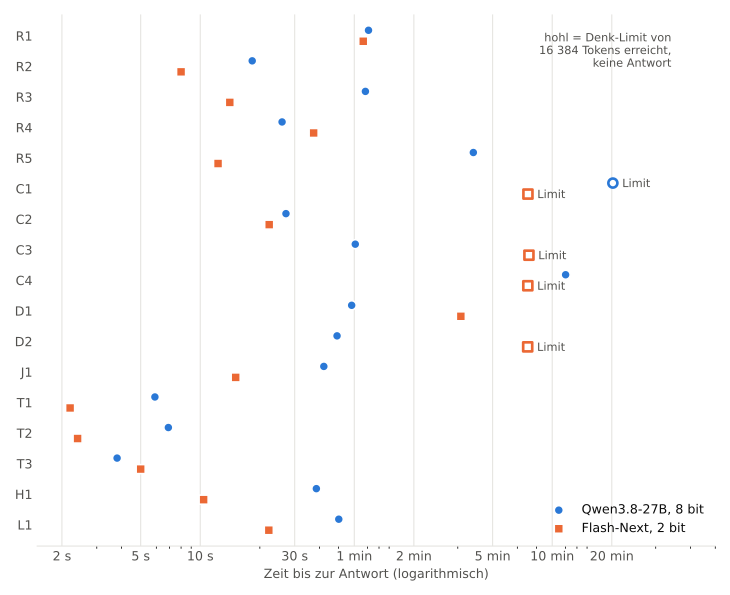
Im Bild sieht man das an den hohlen Markern:
- Qwen-27B hängt in einer Aufgabe pro Lauf, mal in der einen Code-Aufgabe, mal in einer anderen. Weil es langsamer ist, dauert das Warten auf das Limit 20 Minuten.
- Flash-Next hängt in vier Aufgaben, drei davon Code. Jede kostet rund 7,5 Minuten. Dieselbe Deutsch-Aufgabe lief bei einer Wiederholung in 20 Sekunden durch. Die Hänger sind also Zufall, kommen bei Flash-Next aber deutlich öfter vor. Wir vermuten, dass das an der starken Komprimierung auf 2 Bit liegt.
Wenn ein Modell antwortet, ist die Antwort fast immer richtig. Flash-Next hat keine einzige Aufgabe falsch beantwortet; alle verlorenen Punkte sind Hänger. Das Problem ist also nicht fehlendes Können, sondern ein Modell, das nicht zum Ende kommt.
Praxis-Tipp: Wer lokale Modelle in einem Programmier-Agenten nutzt, sollte pro Antwort ein Zeit- oder Token-Limit setzen. Sonst fällt ein Hänger erst nach 10 bis 20 Minuten auf.
Was wir sonst gelernt haben
Die empfohlenen Sampling-Werte helfen nicht. Wir hatten gehofft, dass die Einstellungen von der Modellkarte die Hänger verhindern. Sie tun es nicht, das Ergebnis ist gleich oder leicht schlechter.
Ein Lauf ist eine Stichprobe. Dieselbe Kalenderfrage hat Qwen-27B einmal richtig, einmal mit „Montag“ und einmal mit „Freitag“ beantwortet. Auch welche Code-Aufgabe hängen bleibt, wechselt. Unterschiede von ein bis zwei Punkten sagen deshalb nichts aus. 16 gegen 15 Punkte ist kein Unterschied.
Flash-Next braucht Anlauf. Die erste Anfrage nach dem Start lief nur mit rund 3 Tokens pro Sekunde, weil die Experten erst von der SSD geladen werden. Danach sind es stabil um die 38.
Langer Text bremst beide stark. Bei der Heuhaufen-Aufgabe mit 24 000 Tokens Eingabe sinkt das Tempo auf 2 bis 6 Tokens pro Sekunde, weil das Modell den ganzen Text erst einlesen muss. Gefunden haben beide die Nadel trotzdem.
Unsere Empfehlung
| Einsatz | Modell |
|---|---|
| Programmieren (Agenten wie Cline oder opencode) | Qwen3.8-27B |
| schnelle Einzelfragen, Tool-Aufrufe, Daten herausziehen, kurze Texte | Flash-Next, wenn Tempo zählt |
| beide gleichzeitig laden | nein, zusammen ~110 GB, das ist bei 128 GB zu knapp |
Wie es weitergeht
- Jedes Modell zwei- bis dreimal laufen lassen und den Mittelwert nehmen.
- Qwen-27B ohne Denken testen. Das ist vermutlich viel schneller und hat keine Hänger, rechnet aber vielleicht schlechter.
- Neue Modelle kommen einfach dazu. Den Test haben wir so gebaut, dass alte Ergebnisse vergleichbar bleiben: Neue Aufgaben werden nur angehängt, bestehende nie geändert.
Später wollen wir denselben Test auch auf anderer Hardware laufen lassen, zum Beispiel auf einem Rechner mit NVIDIA-Grafik.